
Agenti AI che migliorano da soli: il ciclo che conta per l'automazione
Far lavorare un agente per decine di ore senza supervisione continua, fino a poco fa, sembrava più una demo da conferenza che uno strumento di lavoro. Il caso che OpenAI ha pubblicato oggi mostra un'architettura concreta: non solo un agente che esegue, ma un ciclo in cui il sistema osserva il proprio comportamento, individua i punti deboli e si migliora. Vale la pena leggerlo con gli occhi di chi deve tenere in piedi automazioni in azienda, non solo con quelli di chi cerca il numero più impressionante.
## Il ciclo che conta davvero
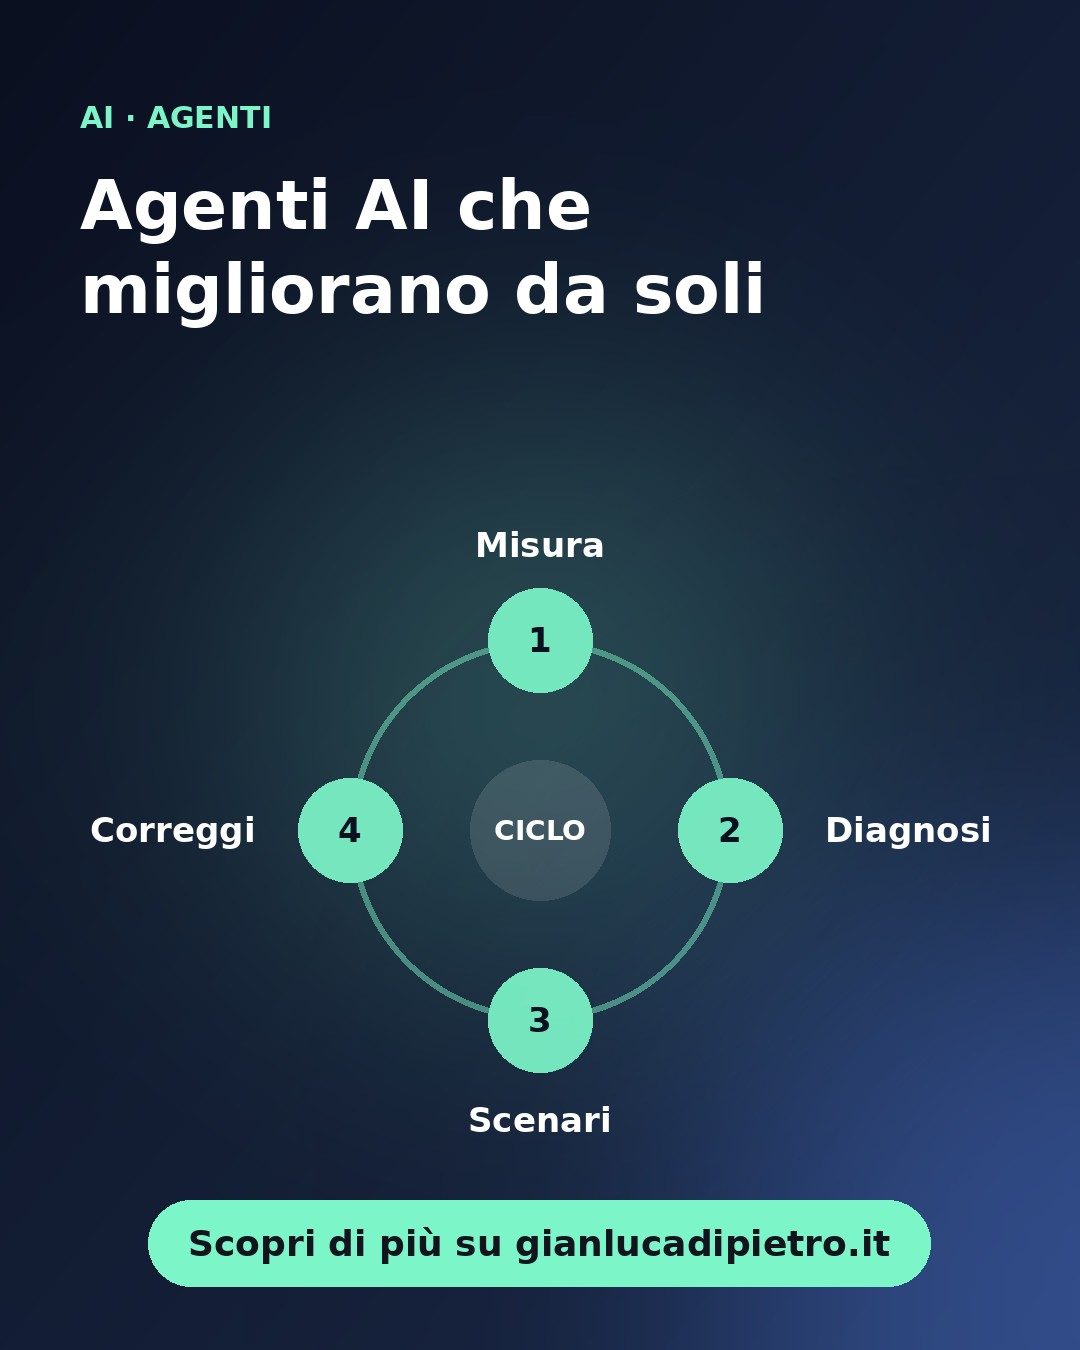
Il meccanismo descritto è semplice da riassumere. Il sistema analizza il comportamento degli agenti, individua problemi ricorrenti e genera scenari sintetici su quei problemi. Poi l'agente viene migliorato e il ciclo ricomincia ogni volta che emergono nuove debolezze. Il punto non è la potenza del modello in sé, ma la chiusura del ciclo: misurare, diagnosticare, simulare, correggere.
Il primo ambito scelto è la finanza quantitativa, e la scelta non è casuale: lì il successo è misurabile. Un backtest produce un numero, una strategia migliora o peggiora. Senza un criterio di successo verificabile, il "miglioramento continuo" di un agente è soltanto ottimismo. Lo stesso vale in un progetto tipico di automazione amministrativa o di supporto clienti: prima di concedere autonomia a un agente serve una metrica chiara (tempo di esecuzione, percentuale di errori, costo in token per compito), altrimenti non si saprà mai se la modifica successiva è stata un passo avanti.
## Dove il tempo si perde davvero
Un dettaglio concreto è istruttivo. Un backtest su un anno di dati azionari statunitensi, a livello di ordine, richiedeva diverse ore. Analizzando migliaia di traiettorie di simulazione, Codex ha individuato il collo di bottiglia e proposto un'ottimizzazione della cache e una tecnica di memory packing, portando il tempo a qualche minuto. Il problema, quindi, non era il modello di ragionamento ma l'infrastruttura attorno.
Un altro sintomo riportato è ancora più familiare a chi lavora con script e job: gli agenti interrogavano ripetutamente lo stato del backtest, riempiendo il contesto con risposte quasi identiche. Chi ha mai scritto un controllo che chiede ogni due secondi a un job se è finito conosce bene il problema. Prima di cambiare modello per risparmiare, conviene quindi fare profiling: cercare polling inutile, log troppo verbosi e contesti che crescono senza controllo.
## Agenti che si fermano e sandbox da verificare
Il dettaglio più utile per chi gestisce sistemi riguarda il caso in cui un agente non completa il compito. Il testo descrive un harness esterno che esamina la traiettoria e sceglie tra tre strade: riprovare, terminare il job oppure escalare a una revisione umana. È esattamente il pattern che andrebbe applicato a qualunque automazione agentica: timeout espliciti, numero limitato di tentativi, coda per i casi falliti e un percorso chiaro verso una persona.
Sul fronte sicurezza, l'articolo racconta che gli agenti stessi eseguono test di penetrazione sulla propria simulazione, per verificare se potrebbero uscire dall'ambiente e raggiungere la rete più ampia. La lezione generale è che l'isolamento non si assume: si testa, e possibilmente lo si testa in modo automatico e ripetuto.
## Pro, contro e cosa il testo non dice
Il vantaggio è evidente: lavori lunghi e parallelizzabili, cicli di miglioramento che non dipendono dal tempo di una persona. I rischi, però, sono altrettanto reali. La complessità operativa cresce, i costi in token vanno monitorati, e un ciclo di ottimizzazione automatica può migliorare la metrica sbagliata invece del risultato reale. Va anche detto che l'articolo non riporta tassi di errore, costi monetari né dettagli implementativi dell'harness. Va letto come un caso di studio, non come un benchmark.
Per chi lavora in Italia, e in particolare nelle PMI, il messaggio pratico è quindi questo: non serve replicare una piattaforma da 10.000 agenti. Serve capire il ciclo, applicarlo a un processo piccolo e misurabile, e costruire attorno all'agente la stessa disciplina che useremmo per un servizio in produzione.
> **In pratica**
>
> 1. **Definisci una metrica prima dell'autonomia.** Per ogni automazione agentica scegli due o tre numeri verificabili (tempo, errori, costo in token) e misurali dall'inizio.
> 2. **Scrivi una politica di recupero esplicita.** Per ogni compito incompleto decidi in anticipo: quanti tentativi, quando terminare, quando passare a una persona. Registra la traiettoria per poterla analizzare.
> 3. **Fai profiling prima di cambiare modello.** Cerca polling, contesti gonfiati e chiamate ripetute nei tuoi job: spesso il costo maggiore non sta nel modello ma nel modo in cui lo usi.
Se stai già sperimentando agenti in azienda, scrivi nei commenti quale processo vorresti automatizzare per primo: è spesso la domanda più utile per capire da dove partire. Se l'articolo ti è stato utile, condividilo con chi gestisce i sistemi nel tuo team e iscriviti per i prossimi approfondimenti.
**Fonte:** OpenAI, "How Third Moment Research runs 10,000 agents for 36+ hours", 14 ottobre 2026: https://openai.com/index/third-moment-research
agenti AI, OpenAI, Codex, automazione, AI per PMI