Scalare lo storage a un miliardo di utenti: 3 lezioni pratiche
Quando si parla di servizi con centinaia di milioni di utenti, l'attenzione va quasi sempre al modello di AI. Chi però gestisce dati e infrastruttura sa che il vero collo di bottiglia, spesso, è un altro: come si distribuiscono le richieste, come si recupera un guasto e come si evita che un carico ne travolga un altro. OpenAI ha pubblicato il secondo capitolo sulla scalabilità del proprio storage online, con dettagli tecnici che, anche al di fuori della sua scala, contengono lezioni utili.
Vale una premessa: i numeri che seguono sono quelli dichiarati dall'azienda e non sono verificati in modo indipendente. Il valore dell'articolo sta nelle scelte di progetto, che si possono trasferire a contesti molto più piccoli.
## Lezione 1: la chiave di partizione non va mai affidata al client
Secondo il racconto di OpenAI, nella prima fase tutto il traffico passava per un unico container condiviso, e le chiavi logiche di partizione erano esposte ai client. Il risultato erano collisioni tra richieste e il cosiddetto effetto «vicino rumoroso», cioè un carico che degrada carichi del tutto non correlati.
Nella pratica di un progetto tipico succede la stessa cosa, in forme più piccole: un'applicazione che costruisce le chiavi dei record a partire da dati che l'utente può modificare, oppure un job notturno che scrive sulle stesse righe del traffico live. La regola da portare a casa è semplice. La chiave di partizione va generata lato server, con uno schema documentato, e i carichi batch vanno separati da quelli interattivi, anche solo con code diverse.
## Lezione 2: container dedicati non sempre sono la risposta
Per isolare i carichi critici, OpenAI ha provato a dare un container dedicato a ciascun caso d'uso importante. Ha risolto parte dei problemi di rumore, ma ha reso la pianificazione della capacità complessa e ha caricato i team di prodotto di un lavoro organizzativo pesante. Il passo successivo è stato tornare a un container condiviso, ma con limiti più fini: throttling delle chiavi molto richieste, priorità (QoS) per i lavori offline come inserimenti massivi ed estrazioni, e scalatura basata anche sull'uso effettivo delle risorse.
Per una PMI l'equivalente è un database condiviso con quote per cliente o per servizio, più un limite esplicito sui job di esportazione. Isolare tutto fisicamente, di solito, costa più di quanto rende.
## Lezione 3: testare il failback, non solo il failover
L'episodio più istruttivo riguarda un'interruzione alla fine del 2024. Un guasto di corrente nella regione primaria ha mostrato tempi di failover di diverse ore per gli account più grandi. Ma il problema più interessante è emerso durante il ritorno alla regione originale: un «connection stampede», con migliaia di client che si riconnettevano insieme e sovraccaricavano il gateway.
Le contromisure dichiarate includono connection pooling, cache dei metadati nel gateway, test condivisi e ambienti di staging di dimensioni simili alla produzione. Chi fa disaster recovery tende a provare il passaggio verso il sito di backup e a dimenticare il ritorno, che è spesso la fase più pericolosa. Un controllo concreto: quante connessioni si aprono nel primo minuto dopo il ripristino? Se la risposta è «non lo sappiamo», il piano di continuità non è completo.
## Cache e invalidazione: il prezzo della velocità
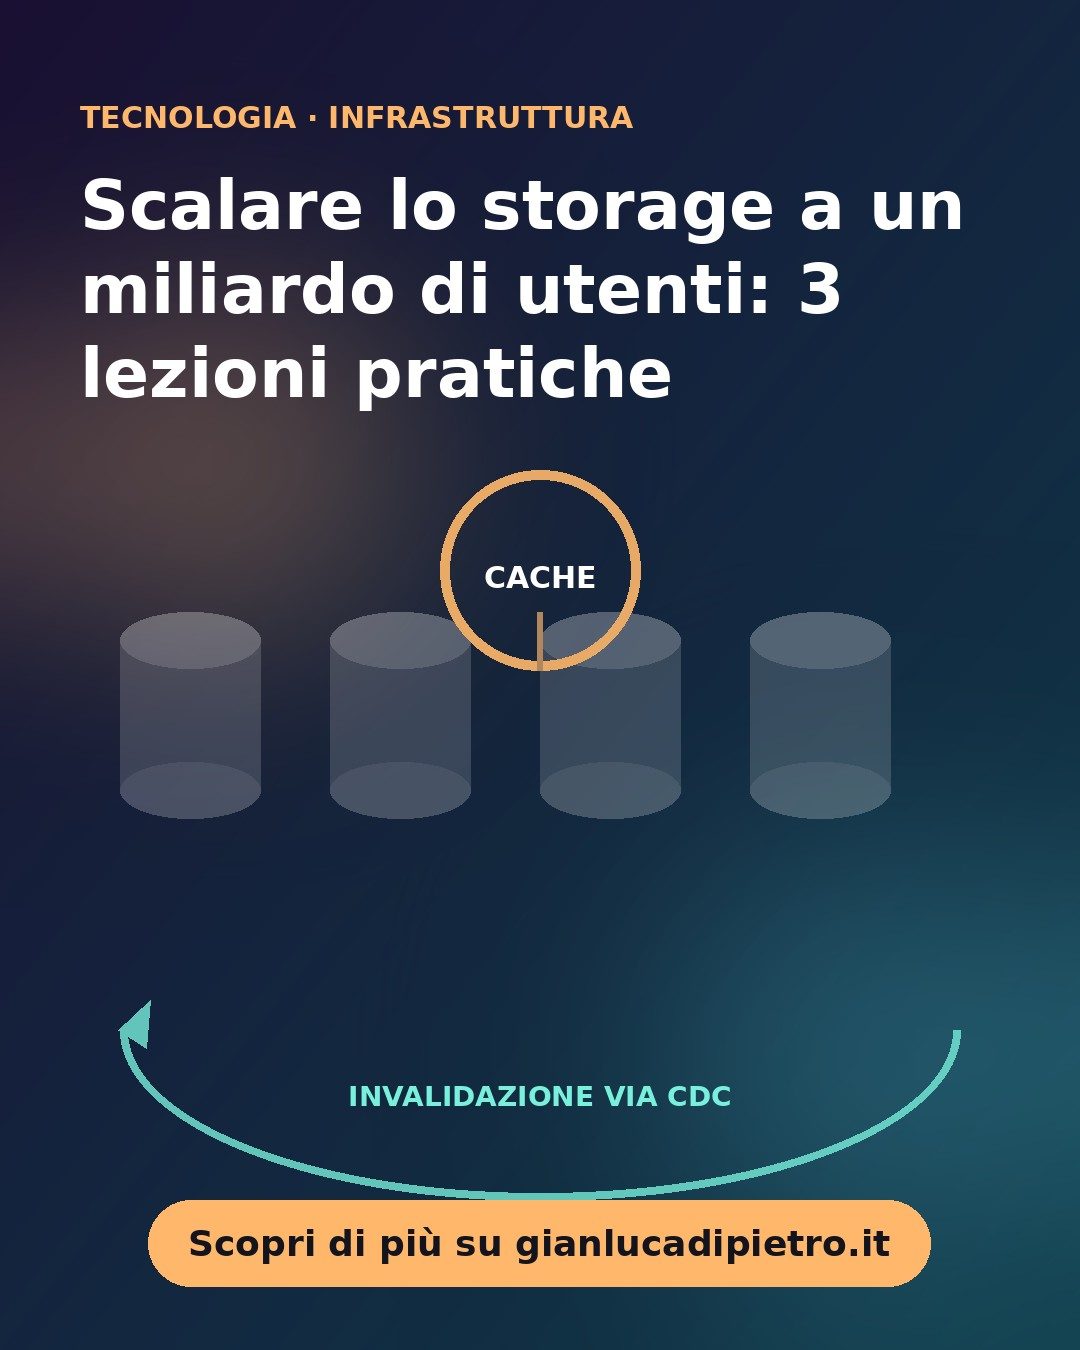
Un altro dato che merita attenzione è la latenza delle letture globali, dichiarata in calo da circa 120 ms a circa 10 ms, con le letture che superano il 90% del traffico. Questo risultato dipende da una cache distribuita, aggiornata a partire dal flusso di modifiche del database e non con il semplice scadere di un timer. Secondo l'azienda, le invalidazioni si propagano in pochi secondi.
Il rovescio della medaglia è la finestra di incoerenza: per qualche secondo un dato può essere vecchio. Nei progetti reali la domanda da porsi è sempre la stessa: quanto ritardo posso accettare su questo dato, e chi se ne accorge? Scriverlo per iscritto, per ogni cache che si introduce, evita molte discussioni in fase di incidente.
> **In pratica**
>
> 1. Controlla come vengono generate le chiavi di partizione o di indice dei tuoi database e separa i carichi batch da quelli interattivi, anche con code diverse.
> 2. Prova il ritorno dal sistema di backup, non solo il passaggio verso di esso, e misura quante connessioni si aprono nel primo minuto.
> 3. Per ogni cache, scrivi la finestra di incoerenza accettabile e il meccanismo di invalidazione, così il trade-off è esplicito.
Se stai affrontando un tema simile nella tua infrastruttura, scrivi nei commenti: è uno dei temi su cui torno più volentieri. Condividi l'articolo con chi gestisce i dati nella tua azienda e iscriviti al blog per i prossimi approfondimenti.
Fonte: OpenAI, «Rapidly scaling online storage to serve over 1 billion ChatGPT users (Part II)», 23 ottobre 2026: https://openai.com/index/scaling-storage-one-billion-users-part-two
storage, scalabilità, infrastruttura, disaster recovery, cache